
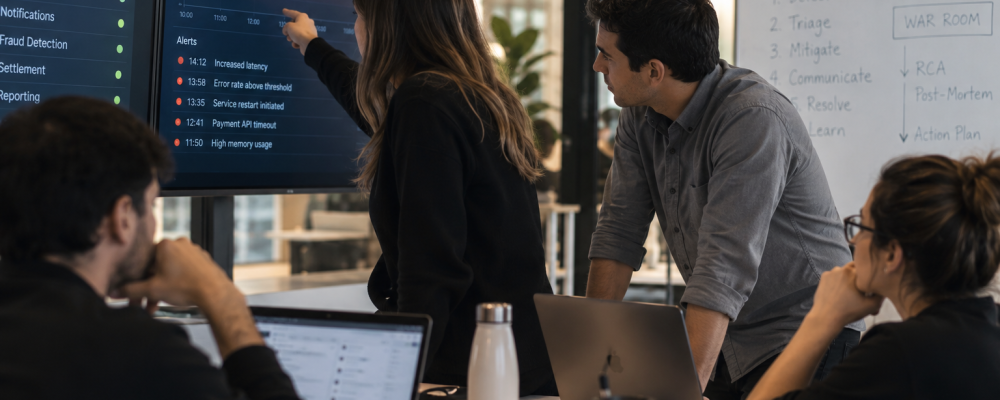
Buscamos sumar un/a SRE Incident & Resilience SR para formar parte de una importante empresa del ecosistema de medios de pago, con foco en la gestión de incidentes críticos, continuidad operativa y confiabilidad de servicios transaccionales.
Tu rol será clave para liderar la gestión de incidentes mayores (P1/P2), coordinar equipos técnicos y proveedores durante situaciones críticas, establecer y evolucionar los procesos de Incident Management y asegurar que cada incidente derive en acciones concretas de mejora y prevención.
Lo que valoramos de tu perfil
- Liderazgo y capacidad para tomar decisiones bajo presión.
- Comunicación clara, precisa y oportuna en situaciones de alta criticidad.
- Capacidad para coordinar equipos multidisciplinarios sin autoridad jerárquica.
- Pensamiento analítico y capacidad para interpretar información técnica y traducirla en impacto de negocio.
- Capacidad de síntesis y organización durante situaciones de crisis.
- Orientación a la resolución de problemas, priorizando la mitigación y recuperación del servicio.
- Rigor documental y seguimiento de acciones hasta su cierre.
- Proactividad y orientación a la mejora continua.
- Capacidad para trabajar en contextos dinámicos y con disponibilidad acorde a esquemas de atención de incidentes.
Tus principales desafíos serán
- Liderar la gestión de incidentes mayores P1/P2, desde la detección y declaración hasta la recuperación y cierre formal.
- Actuar como Incident Commander, coordinando el triage, la mitigación, la recuperación y el escalamiento durante incidentes críticos.
- Coordinar y conducir War Rooms, asignando roles, responsabilidades y prioridades a los diferentes equipos involucrados.
- Definir y evolucionar el Incident Management Operating Model, estableciendo criterios de severidad, escalamiento, comunicación y cierre.
- Diseñar y mantener playbooks de atención de incidentes mayores, contemplando detección, declaración, triage, escalamiento, mitigación, comunicación, recuperación, cierre y RCA.
- Coordinar la interacción entre equipos de SRE, ITSM, Infraestructura, Cloud, Network, Cybersecurity, Desarrollo y Producto, así como proveedores y terceros.
- Liderar la comunicación durante los incidentes hacia las áreas de negocio y stakeholders ejecutivos, asegurando información clara, consistente y oportuna.
- Conducir RCA (Root Cause Analysis) y postmortems, identificando causas raíz y oportunidades de mejora.
- Realizar el seguimiento de las acciones correctivas derivadas de los incidentes hasta su implementación y cierre efectivo.
- Construir y mantener una base de conocimiento operacional, documentando incidentes históricos, decisiones, dependencias, escalaciones y procedimientos de recuperación.
- Definir y monitorear indicadores de gestión como MTTD, MTTA, MTTR, recurrencia y cumplimiento de SLA/OLA.
- Diseñar y ejecutar simulacros y Game Days para validar los procesos de atención y preparación de los equipos ante incidentes críticos.
- Participar en iniciativas de resiliencia y continuidad operativa, identificando oportunidades para reducir la recurrencia y el impacto de incidentes.
- Participar en la transición desde modelos tercerizados de operación hacia un esquema de gestión interno y autónomo.
¿Qué esperamos de vos?
- Experiencia comprobable en Incident Management, Major Incident Management, SRE, Operations, IT Service Management o posiciones similares.
- Experiencia liderando incidentes críticos P1/P2 y War Rooms con participación de múltiples equipos.
- Experiencia actuando como Incident Commander o desempeñando un rol equivalente de coordinación durante incidentes mayores.
- Experiencia definiendo y aplicando modelos de gestión de incidentes, playbooks y matrices de escalamiento.
- Experiencia en RCA, postmortems y seguimiento de acciones correctivas.
- Experiencia trabajando con métricas de incidentes como MTTD, MTTA, MTTR, disponibilidad y recurrencia.
- Experiencia en herramientas de ITSM, gestión de incidentes, alertamiento y seguimiento operativo.
- Conocimientos de SRE, SLI, SLO y Error Budget.
- Conocimientos de arquitecturas distribuidas, microservicios y ambientes Cloud, preferentemente AWS.
- Conocimientos de monitoreo y observabilidad: logs, métricas, trazas, dashboards y alertas.
- Conocimientos de continuidad operativa, resiliencia y recuperación ante incidentes.
- Experiencia trabajando con proveedores y terceros en procesos de escalamiento será valorada.
- Experiencia en medios de pago o plataformas transaccionales de alta disponibilidad será valorada.
- Conocimientos de ITIL / IT Service Management.
- Certificación ITIL o formación equivalente será valorada.
- Formación universitaria o terciaria en Sistemas, Informática, Tecnología o carreras afines será valorada.
¿Qué ofrece el cliente?
- Relación de dependencia directa con empresa líder en soluciones de pagos.
- Modalidad híbrida (CABA)
- 30 días al año de trabajo remoto desde cualquier parte del mundo.
- Bono anual por performance + revisión salarial periódica.
- Reintegro mensual de internet y crédito en plataformas de delivery.
- Prepaga de primer nivel para vos y tu grupo familiar.
- Días hábiles de vacaciones + licencias extendidas de familia.
- Acceso a formación continua, certificaciones y convenios educativos.
- Espacios de trabajo atractivos y tecnológicos.
